Computer Vision in der Praxis: Vom KI-Modell zur produktiven Lösung
Warum das KI-Modell erst der Anfang ist
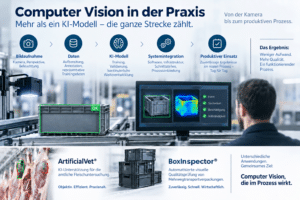
Ein Computer-Vision-Modell kann im Test eine beeindruckende Erkennungsleistung erzielen. Bilder werden zuverlässig klassifiziert, Objekte präzise erkannt und relevante Merkmale korrekt identifiziert. Technisch betrachtet kann das Ergebnis hervorragend aussehen.
Doch ob daraus auch eine Lösung entsteht, die Tag für Tag zuverlässig in einem produktiven Prozess funktioniert, entscheidet sich an ganz anderen Stellen.
Diese Erfahrung machen wir bei cimt in unterschiedlichen Computer-Vision-Projekten. Zwei Beispiele dafür sind ArtificialVet® und BoxInspector®. Die Anwendungen unterscheiden sich deutlich – und zeigen gerade deshalb, welche Faktoren für produktive Computer Vision entscheidend sind.
ANWENDUNGSBEISPIELE
Zwei Anwendungen, eine grundlegende Herausforderung
Bei ArtificialVet® unterstützt Computer Vision die amtliche Fleischuntersuchung. Kameras erfassen Schlachtkörper, eine KI analysiert die Bilder und stellt digitale Vorbefunde bereit. Die abschließende fachliche Bewertung bleibt dabei bei den Verterinären.
Beim BoxInspector® geht es um einen anderen Prozess: die automatisierte visuelle Qualitätsprüfung von Euro-Boxen bzw. Mehrwegtransportverpackungen, beispielsweise Fleisch- und Bäckereikisten. Das System erkennt definierte Qualitätsmerkmale und kann die Informationen unmittelbar in den weiteren Prozess einfließen lassen.
Die fachlichen Anforderungen könnten unterschiedlicher kaum sein. Technologisch begegnen uns jedoch viele ähnliche Fragestellungen.
BILDAUFNAHME & BILDQUALITÄT
Die KI beginnt vor dem Modell
Wenn über Computer Vision gesprochen wird, steht häufig das KI-Modell im Mittelpunkt. Welche Architektur wird verwendet? Wie hoch ist die Accuracy? Wie groß ist der Trainingsdatensatz?
In der Praxis beginnt die Qualität einer Computer-Vision-Lösung jedoch bereits viel früher.
Wo wird die Kamera positioniert? Aus welcher Perspektive wird das Objekt aufgenommen? Wie konstant ist die Beleuchtung? Wie groß sind Abstand und Bildausschnitt? Können Bilder auch bei wechselnden Umgebungsbedingungen reproduzierbar erfasst werden?
Ein leistungsfähiges Modell kann eine ungeeignete Bildaufnahme nur begrenzt kompensieren. „Garbage in, garbage out“ gilt bei Computer Vision besonders unmittelbar. Deshalb gehören Kamera, Optik, Beleuchtung und die Gestaltung der Aufnahmesituation von Anfang an zur Entwicklung der Lösung.
NUTZEN STATT ACCURACY
Accuracy allein schafft noch keinen Nutzen
Unsere Empfehlung beginnt nicht beim Produkt, sondern bei Ihrer Fragestellung. Auch eine hohe Erkennungsgenauigkeit ist noch kein Business Case.
Die entscheidende Frage lautet nicht nur: Was kann die KI erkennen? Sondern: Welche Information wird im konkreten Prozess benötigt und was geschieht anschließend damit?
Ein erkanntes Merkmal entfaltet erst dann einen Nutzen, wenn daraus ein sinnvoller Prozessschritt folgt. Das kann eine zusätzliche Prüfung sein, eine Dokumentation, eine Ausschleusung, eine Qualitätsentscheidung oder die Übergabe von Informationen an ein anderes IT-System.
Deshalb sollte ein Computer-Vision-Projekt nicht mit der Suche nach einem möglichst leistungsfähigen Modell beginnen. Am Anfang sollte der Prozess stehen: Wo entsteht heute Aufwand? Wo fehlen objektive oder reproduzierbare Informationen? Welche Entscheidung könnte durch Bilddaten besser unterstützt oder automatisiert werden?
VOM PROOF OF CONCEPT ZUR PRODUKTION
Produktion ist anders als das Labor
Eine weitere Erfahrung zeigt sich spätestens beim Übergang vom Proof of Concept in den produktiven Betrieb: Die reale Welt hält sich nicht an den Testdatensatz.
Objekte variieren. Lichtverhältnisse verändern sich. Kameras können sich minimal verstellen. Verschmutzungen treten auf. Materialien oder Verpackungen verändern sich. Gleichzeitig läuft der operative Prozess weiter.
Ein produktives System muss mit dieser Realität umgehen können.
Dazu gehört aus unserer Sicht auch, Veränderungen systematisch zu erkennen und das Modell bei Bedarf weiterzuentwickeln. Ein integrierter Nachlernprozess kann deshalb ein wesentlicher Bestandteil einer stabilen Computer-Vision-Lösung sein. Machine Learning endet nicht zwangsläufig mit dem ersten produktiven Modell, wodurch z. B. Kisten in neuen Farben einfach nachgelernt werden können
SYSTEM ENGINEERING
Computer Vision ist System Engineering
Damit verändert sich auch der Blick auf das Projekt.
Produktive Computer Vision ist nicht ausschließlich ein Data-Science-Thema. Kamera und Beleuchtung, Software, KI-Modell, IT-Infrastruktur, Schnittstellen und Fachprozess müssen zusammenspielen.
Das beste Modell nützt wenig, wenn Bilder nicht zuverlässig aufgenommen werden, Ergebnisse nicht rechtzeitig zur Verfügung stehen oder sie nicht in den operativen Prozess integriert werden können.
Gerade diese Verbindung der unterschiedlichen Disziplinen macht Computer-Vision-Projekte anspruchsvoll – und gleichzeitig interessant.
ROLLE DER KI IM PROZESS
Die Rolle der KI bestimmt der Prozess
Dabei bedeutet der Einsatz von KI nicht automatisch vollständige Automatisierung.
Bei ArtificialVet® unterstützt die Bilderkennung beispielsweise das Fachpersonal mit digitalen Vorbefunden. Die abschließende Bewertung erfolgt weiterhin durch die zuständigen Experten.
In anderen Szenarien kann dagegen die automatisierte Bearbeitung eines klar definierten Prüfschritts das richtige Ziel sein.
Entscheidend ist daher nicht die Frage, wie viel sich technisch automatisieren lässt, sondern welche Rolle der KI im jeweiligen Prozess sinnvoll ist.
Unser wichtigstes Learning aus produktiven Computer-Vision-Anwendungen lautet deshalb:
Ein Computer-Vision-Projekt ist dann erfolgreich, wenn am Ende nicht mehr über die KI gesprochen werden muss.
Sondern wenn sie zuverlässig ihren Teil in einem funktionierenden Prozess erledigt.
Genau diese Strecke – von der Aufnahme eines Bildes über das KI-Modell bis zur Integration des Ergebnisses in einen realen Geschäfts- oder Produktionsprozess – ist für uns der Kern produktiver Computer Vision.
FAQ
Häufige Fragen zu Computer Vision
Computer Vision bezeichnet Verfahren, mit denen Computer Informationen aus Bildern oder Videos erkennen und verarbeiten können. Dazu gehören beispielsweise die Klassifikation von Bildern, das Erkennen von Objekten oder die genaue Lokalisierung bestimmter Bereiche innerhalb eines Bildes.
In industriellen Anwendungen kann Computer Vision zum Beispiel zur Qualitätskontrolle, zur Erkennung von Abweichungen oder zur Unterstützung von Prüfprozessen eingesetzt werden.
Für das Training benötigt die KI zunächst geeignete Bilddaten. Diese Bilder werden typischerweise mit Informationen versehen, die beschreiben, was auf ihnen zu sehen ist. Je nach Aufgabenstellung können das beispielsweise Objektklassen, Qualitätsmerkmale oder markierte Bildbereiche sein.
Während des Trainings lernt das Modell anhand vieler Beispiele, charakteristische visuelle Merkmale zu erkennen. Anschließend wird mit separaten Testdaten überprüft, wie zuverlässig das Modell auch mit bisher unbekannten Bildern arbeitet.
Entscheidend ist dabei nicht nur die Menge der Trainingsdaten, sondern vor allem deren Qualität und Repräsentativität für den späteren Einsatz.
Bei der Segmentierung wird ein Bild nicht nur als Ganzes bewertet. Stattdessen ordnet das Modell einzelne Pixel bestimmten Objekten oder Bereichen zu.
So kann beispielsweise nicht nur erkannt werden, dass ein bestimmtes Merkmal vorhanden ist, sondern auch wo genau es sich befindet und welche Form oder Ausdehnung es hat.
Segmentierung eignet sich deshalb besonders für Anwendungen, bei denen die genaue Position oder Fläche eines Merkmals relevant ist.
Bei der Klassifikation wird ein gesamtes Bild einer bestimmten Kategorie zugeordnet.
Bei der Objekterkennung erkennt die KI einzelne Objekte innerhalb eines Bildes und bestimmt deren Position, beispielsweise durch einen Rahmen.
Bei der Segmentierung erfolgt die Erkennung noch detaillierter: Einzelne Pixel werden bestimmten Objekten oder Bereichen zugeordnet.
Welche Methode sinnvoll ist, hängt von der konkreten Aufgabenstellung ab.
Dafür gibt es keine allgemeingültige Zahl. Der Bedarf hängt unter anderem von der Komplexität der Aufgabe, der Variabilität der Objekte und den Umgebungsbedingungen ab.
Entscheidender als eine möglichst große Datenmenge ist häufig, ob die Trainingsdaten die Realität ausreichend abbilden. Unterschiedliche Objektvarianten, Perspektiven, Beleuchtungssituationen oder relevante Sonderfälle sollten im Datensatz vertreten sein.
Ein KI-Modell analysiert die Bildinformationen, die ihm zur Verfügung stehen. Verändern sich Licht, Schatten, Reflexionen oder Kontraste stark, kann sich auch das Erscheinungsbild eines Objekts verändern.
Eine kontrollierte und möglichst reproduzierbare Beleuchtung verbessert deshalb die Qualität der Bilddaten und erleichtert dem Modell die zuverlässige Erkennung.
Die Gestaltung der Aufnahmesituation ist daher ein wichtiger Bestandteil eines Computer-Vision-Systems.
Nicht in jedem Fall – in vielen produktiven Anwendungen ist es aber sinnvoll, die Qualität des Modells kontinuierlich zu beobachten.
Verändern sich beispielsweise Produkte, Materialien, Kamerapositionen oder Beleuchtungssituationen, können neue Trainingsdaten erforderlich werden. Ein strukturierter Nachlernprozess hilft dabei, das Modell an relevante Veränderungen anzupassen.
Dafür werden verschiedene Kennzahlen verwendet. Welche Kennzahl relevant ist, hängt von der konkreten Aufgabe ab.
Neben klassischen Größen wie Accuracy sind beispielsweise Precision, Recall oder bei Segmentierungsaufgaben die Übereinstimmung zwischen vorhergesagten und tatsächlich markierten Bildbereichen relevant.
Für eine produktive Lösung reicht eine gute Kennzahl allein jedoch nicht aus. Entscheidend ist letztlich, ob das gesamte System im realen Prozess zuverlässig die benötigten Informationen liefert.
Computer Vision in der Lebensmittelindustrie
HookTracing®, eine KI-Bilderkennung für Tiere
MeatVision, ein KI-System zur visuellen Erkennung von (Fleisch-) Produkten
Autoren
Dr. Thorsten Kuhlmann
Telefon: +49 (0)40 53302-0
E-Mail: Thorsten.Kuhlmann@cimt-ag.de
Dr. Harald Schallner
Telefon: +49 (0)40 53302-0
E-Mail: Harald.Schallner@cimt-ag.de
Sie möchten mehr über den Einsatz von Computer Vision in der Praxis erfahren?
Von Dr. Thorsten Kuhlmann und Dr. Harald Schallner, 23. September 2026