GEMA – Zentrale Prozesssteuerung mit Camunda
Die GEMA orchestriert mit Camunda über 580 teamübergreifende Prozesse mit Millionen von Datensätzen zentral. cimt entwickelte die Prozesssteuerung und begleitete die Migration in die Google Cloud.
Unternehmen: Cosnova GmbH
Branche: Kosmetikindustrie
Firmensitz: Sulzbach (Taunus), Hessen
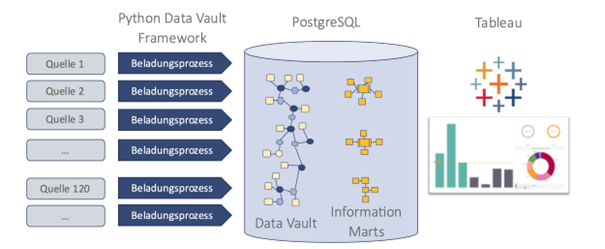
Einsatz einer Data Vault Architektur und eines Python / PostgreSQL basierten Implementierungsframeworks, um agil, flexibel und effizient Daten aus verschiedensten Quellen auf einer zentralen BI-Plattform bereitzustellen.
Cosnova ist ein führender europäischer Kosmetikanbieter und Mengenmarktführer in Deutschland mit verschiedenen Produktkategorien und Marken – u.a. den Kosmetikserien Essence und Catrice die überwiegend über Drogerie Discounter vertrieben werden.
An zentraler Stelle die Verkaufszahlen bereitstellen, welche von den diversen Online-Shops und Drogerieketten gemeldet werden. Des Weiteren den Erfolg von Online-Marketingkampagnen auf den diversen Plattformen zentral verfügbar machen.
Die sehr hohe Anzahl an externen Datenquellen führt aufgrund fehlender Standards zu einer großen Varianz bezüglich der Inhalte, Formate und Datenqualität in den gelieferten Daten. Sowohl die Extraktion als auch die Korrektur erfordern ein hohes Maß an Flexibilität in der Datenmodellierung und bei der Implementierung der Ladestrecken.
Für die Integration und Datenbereitstellung wurde eine Data Warehouse Plattformt mit folgenden zentralen Methoden und Technologien aufgebaut:
Die Dokumentation erfolgt in dem schon beim Kunden vorhandenen Confluence. Für die Projekt- und Aufgabensteuerung wird Jira eingesetzt.
Dank der Data Vault Architektur und Modellierung können die verschiedenen eingehenden Datenstrukturen problemlos in das Data Warehouse geladen werden. Die notwendigen Bereinigungsschritte und Transformationen zur Angleichung erfolgt beim Übergang in den zentralen Business Vault: Von dort werden die nun gleichförmigen Daten mit Produktinformationen angereichert und Tableau zur Visualisierung übergeben.
Die Implementierung in Python ermöglicht die Extraktion von Daten aus beliebigen Formaten und Strukturen. So war es möglich auch Dateien zu parsen, in denen die Daten pivotisiert dargestellt sind, Spaltenpositionen von Monat zu Monat wechseln oder die Ursprungsposition der Daten in einer Matrix je nach Monat, Marke oder Shop verschieden ist.
Die gleiche Flexibilität gilt für die Methoden der technischen Validierung der Formate und die Bestimmung, welche Daten als aktuell geliefert angesehen werden.
Die Data Vault Grundprinzipien bzgl. der zu speichernden Metadaten und der rigorosen Historisierung waren mehrfach eine wesentliche Stütze bei der effizienten Suche nach der Ursache von Datenfehlern. Ebenso konnte dank der strikten Trennung von Raw Vault und Business Vault sehr flexibel und zügig auf spät erkannte Datenqualitätsprobleme reagiert werden.
Als Spezialist für Data Management mit mehr als 24 Jahre Erfahrung, wurden wir für folgende Aufgaben herangezogen:
cimt Python ETL Framework

Die GEMA orchestriert mit Camunda über 580 teamübergreifende Prozesse mit Millionen von Datensätzen zentral. cimt entwickelte die Prozesssteuerung und begleitete die Migration in die Google Cloud.

Panasonic Europe digitalisiert Hunderte Freigabeprozesse mit einem generischen BPMN-Modell und DMN-Entscheidungstabellen in Camunda; cimt verantwortet das methodische Design und unterstützt bei der Umsetzung.
Die GEMA nutzte für ihr Reporting SQL, Excel und manuelle Abstimmungen. cimt begleitete den Aufbau einer Lakehouse-Plattform mit Databricks, über die Fachbereiche ihre Daten automatisiert erhalten.
Sie sehen gerade einen Platzhalterinhalt von Facebook. Um auf den eigentlichen Inhalt zuzugreifen, klicken Sie auf die Schaltfläche unten. Bitte beachten Sie, dass dabei Daten an Drittanbieter weitergegeben werden.
Mehr Informationen